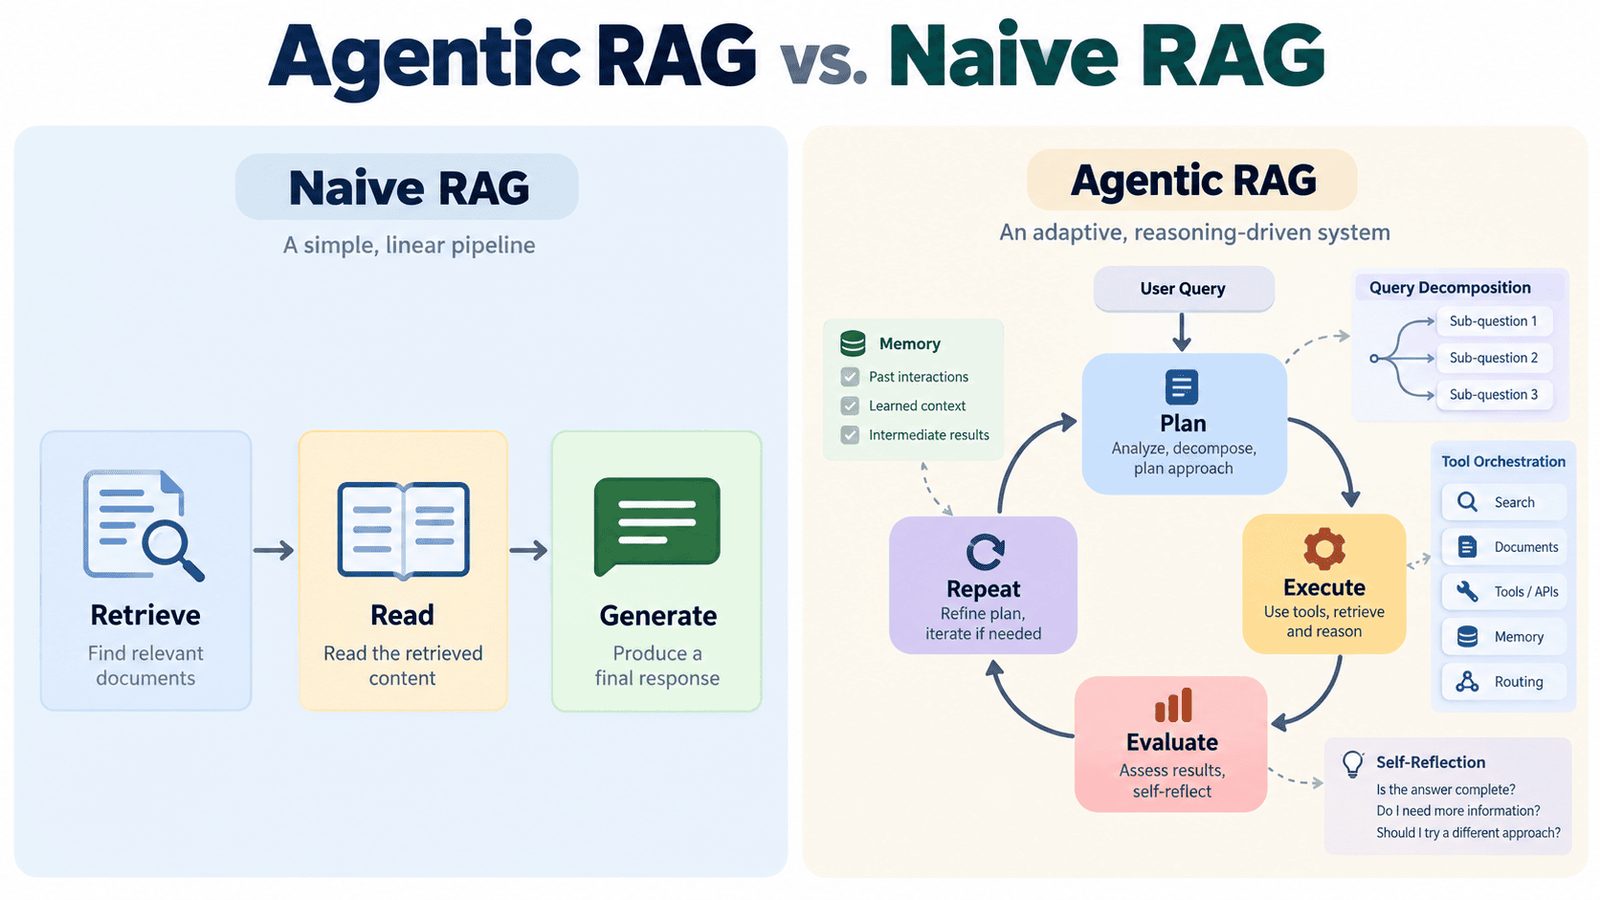
Стандартные конвейеры RAG устроены линейно: они выполняют поиск один раз, передают полученные результаты модели и генерируют ответ. Большие языковые модели галлюцинируют, уверенно выдавая правдоподобно звучащие ответы, которые фактически неверны, если у систем нет доступа к проверенным и актуальным данным. Подход Retrieval-Augmented Generation привязывает ответы моделей к внешним источникам знаний и снижает количество галлюцинаций в корпоративных приложениях. Стандартные конвейеры RAG линейны, потому что извлекают информацию единожды, передают ее модели и формируют ответ. Когда компании внедряют такие системы в более сложные рабочие процессы, возникает новая проблема.
Архитектура наитивного извлечения данных
Наивный RAG, который также называют стандартным RAG, использует жесткий трехэтапный конвейер, состоящий из поиска (Retrieve), чтения (Read) и генерации (Generate). Пользователь отправляет запрос, система преобразует его в векторное представление и запускает поиск сходства по векторной базе данных. При загрузке документов в наивном RAG они разбиваются на фрагменты и конвертируются в плотные векторы с помощью модели эмбеддингов. Это стало настоящим прорывом, позволив создавать корпоративные системы ответов на вопросы, внутренние справочные ассистенты и средства суммирования документов, опирающиеся на проверенные источники.
Главная уязвимость этой архитектуры заключается в ее линейности, при которой единственный проход поиска либо успешен, либо нет. При сбое многошагового рассуждения единичный векторный поиск с высокой вероятностью не сможет связать разрозненные данные, если информация хранится в разных документах. Корпоративные среды показывают, что доля ошибок в многошаговых запросах резко возрастает, когда контекст рассредоточен по изолированным хранилищам. Это приводит к системным сбоям, при которых однопроходный механизм извлекает шум вместо полезного сигнала. Ответы на сложные запросы требуют нескольких шагов, но стандартный RAG делает лишь одну попытку поиска, заставляя модель генерировать ответы на основе неполного или нерелевантного контекста.
Переход к автономному рассуждению
Агентный RAG наделяет систему способностью самостоятельно определять стратегию поиска, оценивать найденное и повторять процесс до получения точного ответа. Агентный RAG рассматривает большую языковую модель как автономный движок рассуждений, который управляет всем процессом извлечения информации. Такой подход работает в цикле по стадиям: планирование (Plan), выполнение (Execute), оценка (Evaluate) и повтор (Repeat). Вместо того чтобы считать поиск единичным фиксированным шагом, эта архитектура преодолевает фундаментальные ограничения линейной обработки данных.
При оценке экономики затрат на инференс в сравнении с убытками от человеческих ошибок традиционные однопроходные конвейеры перекладывают финансовое бремя непосредственно на операционные команды. Хотя запуск многошаговых агентских циклов потребляет больше вычислительных токенов и увеличивает первотраты на инференс, альтернативой выступают скрытые расходы на ручную коррекцию, задержки в принятии решений и критические искажения из-за сбоев однопроходного поиска. В критически важных корпоративных внедрениях предотвращение всего одного сбоя многошагового запроса с лихвой перекрывает незначительный рост вычислительных издержек. По мере масштабирования стратегий автоматизации экономика все сильнее склоняется в пользу систем, которые проверяют собственные результаты, а не заставляют операторов разгребать последствия ошибок линейного поиска.