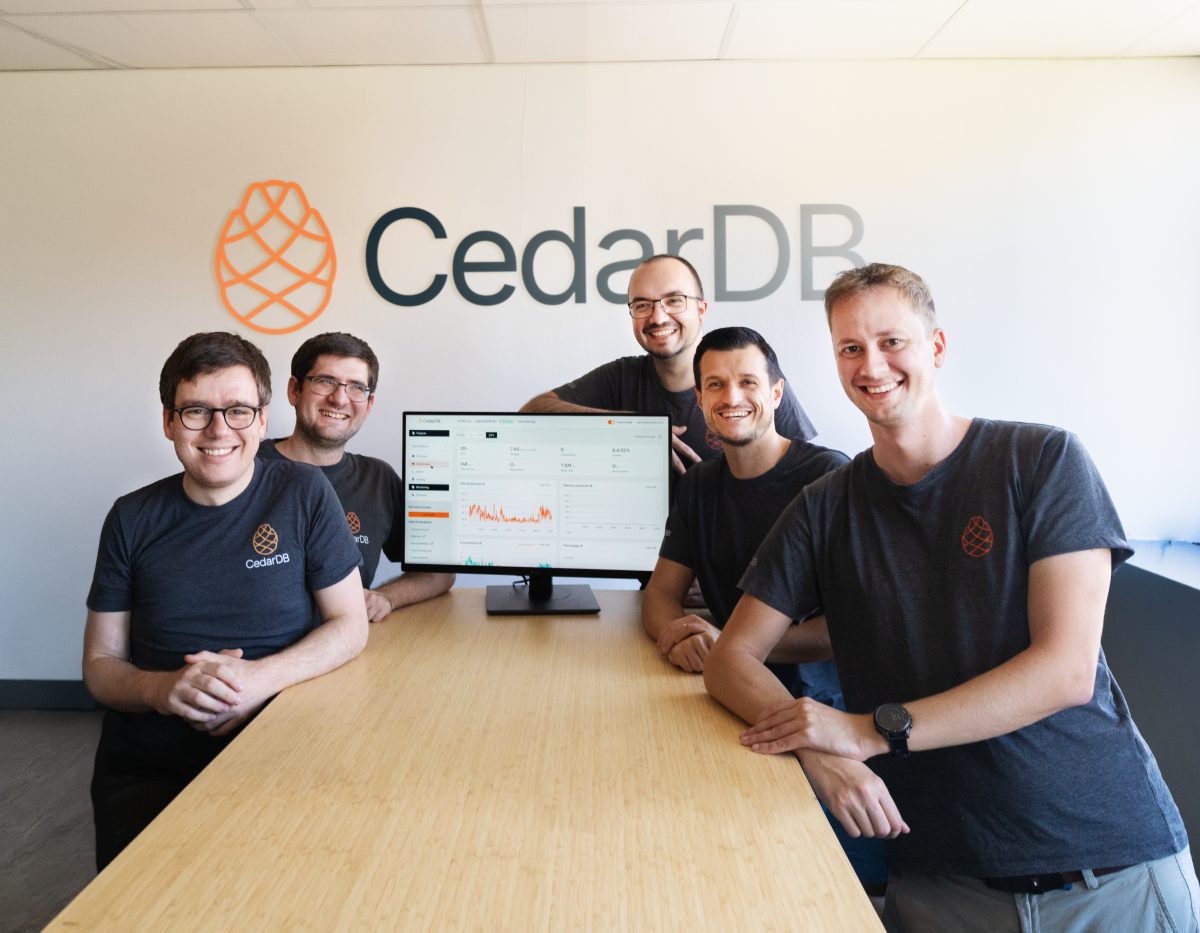
Корпоративная инфраструктура сталкивается со скрытой финансовой нагрузкой по мере того, как автономные ИИ-агенты требуют мгновенных ответов на запросы на естественном языке, для поддержки которых традиционное разделение баз данных никогда не создавалось. На протяжении десятилетий технологический стек предприятий поддерживал четкий операционный водораздел: аналитические базы данных хранили исторические данные для отслеживания трендов, в то время как транзакционные системы обрабатывали ежедневные записи о заказах и платежах. Это архитектурное разделение теперь порождает серьезные задержки и тяжелые издержки, поскольку компании развертывают агентов, требующих одновременного доступа к обеим средам. По словам сооснователя и генерального директора мюнхенского стартапа CedarDB Морица Сихерта, разработанный ими движок баз данных CedarDB поддерживает как аналитические, так и транзакционные запросы, отвечая на меняющиеся требования агентного ИИ.
CedarDB функционирует как спин-офф Технического университета Мюнхена, созданный на базе Umbra — исследовательского проекта, разработанного с нуля для превхождения устаревших движков по скорости обработки за счет максимального задействования возможностей современного железа. Опираясь на пятерых исследователей Umbra в качестве сооснователей, стартап спроектировал свою систему так, чтобы обеспечивать более высокую производительность без требования дополнительных процессоров, памяти или вычислительной мощности от корпоративных покупателей. Поддержание раздельных хранилищ OLTP (Online Transaction Processing) и OLAP (Online Analytical Processing) обрекает организации на двойные капитальные затраты: предприятия вынуждены выделять, лицензировать и обслуживать различные аппаратные кластеры, дублировать конвейеры данных и управлять задержками синхронизации лишь для подпитки двух сред. Возникающие операционные расходы быстро растут за счет непрерывного обслуживания, сложной накладной инфраструктуры ETL и ручной настройки. Унифицируя транзакционные и аналитические рабочие нагрузки на едином движке, архитектуры баз данных обходят эти избыточные копии данных, сокращая как аппаратный след, так и регулярное операционное торможение, от которого страдают устаревшие настройки.
CedarDB была совместима с PostgreSQL, системой баз данных с открытым исходным кодом.
Такая целенаправленная совместимость удерживает затраты на миграцию на низком уровне, поскольку корпоративные пользователи избегают расходов на переписывание существующих приложений. Как отметил Сихерт, эта структура базы данных удобно совпадает с той самой логикой, которую крупные языковые модели усваивают чаще всего в ходе фаз своего обучения. Крупные языковые модели поглощают огромные массивы кода, реляционных схем и структурированных запросов к базам данных во время обучения, эффективно обучаясь рассуждать поверх унифицированных реляционных моделей, а не фрагментированных, разделенных хранилищ данных. Когда автономные агенты пытаются опрашивать разделенные архитектуры OLTP и OLAP, они вынуждены генерировать сложные, фрагментированные многошаговые вызовы, которые не отражают ни их обучающие данные, ни эффективные пути выполнения, тогда как унифицированные движки естественным образом выстраиваются в соответствии с реляционными паттернами, зашитыми в веса LLM при обучении.
Изменение экономики инфраструктуры
Рыночная экономика управления данными заставляет вендоров переосмыслять то, как унифицированные рабочие нагрузки функционируют в рамках корпоративных бюджетов. Потратив десятилетие на разработку своей базовой технологии, стартап запустил CedarDB Enterprise в качестве решения для локального развертывания наряду со своей бесплатной версией CedarDB Community Edition, о которой было объявлено в мае прошлого года одновременно с привлечением 5,3 миллиона евро посевного финансирования при оценке примерно в 6 миллионов долларов. После фаз бета-тестирования с аккаунтами из листа ожидания компания объявила об ограниченной доступности CedarDB Cloud на сцене TechCrunch Disrupt.
Конкуренты спешат занять ту же архитектурную нишу по мере того, как корпоративные ИТ-бюджеты сжимаются вокруг сложных внедрений ИИ. На своем саммите Data + AI Summit американский гигант в сфере данных Databricks назвал эру агентов главным драйвером запуска LTAP — новой архитектуры данных, нацеленной на объединение транзакций, аналитики, потоковой передачи и операционных данных в рамках единой копии хранилища в озере.
В то время как Databricks нацеливается на крупномасштабные среды озер данных, CedarDB планирует обслуживать своих первых облачных пользователей с помощью текущей команды из 14 человек перед масштабированием штата после получения дальнейшей рыночной динамики и последующих раундов финансирования.
Уничтожит ли этот подход с унифицированным хранением дорогие задержки устаревших корпоративных стеков или же трение при миграции сохранит доминирование разрозненных хранилищ данных?