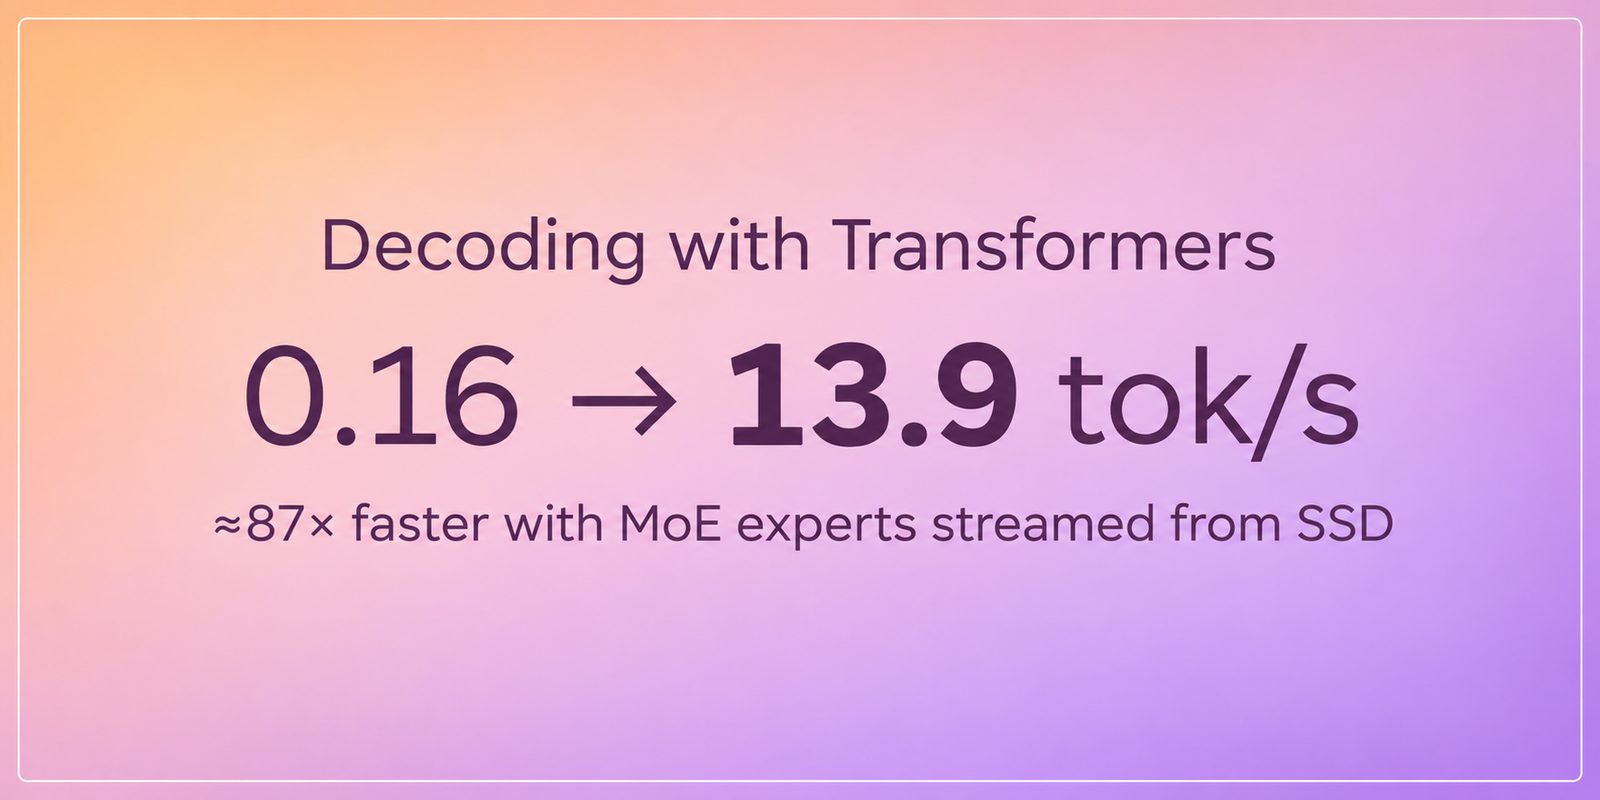
Капитальные затраты на серверные мульти-GPU кластеры можно обойти, если массивные разреженные модели транслируют свои параметры напрямую из локального твердотельного накопителя. Технические тесты разработчика Tarek Ziadé показывают, что стриминг экспертов архитектуры MoE напрямую с SSD отстает от специализированного движка Strata всего на 6% по скорости генерации токенов.
Этот бенчмарк в корне меняет юнит-экономику локальной инфраструктуры искусственного интеллекта. Зависимость от проприетарных облачных API формирует постоянные операционные расходы и выводит конфиденциальные данные за пределы защищенного периметра компании. Передача весов тяжелых разреженных моделей напрямую с локального диска подрывает монополию корпоративных дата-центров на сложные архитектуры, делая приватный автономный инференс коммерчески доступным решением.
Жизнеспособность такого подхода упирается в пропускную способность потребительских шин передачи данных: способны ли они обеспечить адекватную скорость генерации без критических задержек. Ранее оптимизационные проекты решали проблему плотных параметров жестким сжатием моделей. Например, 2026-08-22 оптимизированный движок инференса NInfer сжал мультимодальную MoE-модель Ornith-1.5-35B-A3B исходным объемом 143.84 GB до артефакта размером 21.22 GiB. Однако развертывание полноразмерных разреженных сетей без потерь при квантовании требует принципиально иной архитектуры выгрузки параметров.
Узкие места выгрузки памяти в существующих средах выполнения
Стандартные фреймворки инференса демонстрируют глубокие структурные изъяны при выполнении разреженных моделей смеси экспертов (MoE) на аппаратных средствах с ограниченными ресурсами. В техническом отчете, опубликованном в блоге Hugging Face, Tarek Ziadé проанализировал распределение вычислений по ярусам памяти в существующих движках. Инженерные механизмы выявили жесткие компромиссы: фреймворк llama.cpp размечает файл формата GGUF через mmap и способен удерживать экспертов в оперативной памяти процессора, гарантируя, что веса не перегружают шину PCIe при передаче активаций. Однако когда суммарный объем экспертов превышает объем физической RAM, кэш страниц операционной системы начинает буксовать (thrashing), а экспериментальный кэш экспертов на GPU вызывает фрагментацию вычислительного графа с потерей около 10% производительности даже в тех случаях, когда веса полностью помещаются в память.
В свою очередь, vLLM направляет потоки весов через каналы хост-памяти со специфическими потерями эффективности.
«Параметр --cpu-offload-gb N во vLLM выделяет N ГБ весов в закрепленной оперативной памяти (pinned RAM), после чего ядра читают их на месте через интерфейс PCIe».
Поскольку vLLM не кэширует направленные таким образом веса, часто вызываемый эксперт вынужден циклично прокачиваться через шину PCIe при генерации каждого отдельного токена. Ограничение передачи параметрами для выгрузки только экспертов удваивает скорость vLLM, однако альтернативный бэкенд с предварительным копированием групп слоев показал скорость ниже 1 токена в секунду. Параллельно стандартная библиотека Transformers опирается на хуки Accelerate, копируя весь банк экспертов конкретного слоя на GPU перед прямым проходом — перемещая абсолютно всех экспертов ради фактического использования восьми или десяти. Возникает инженерная задача: как исключить перемещение избыточных банков экспертов по шине и избежать при этом критических задержек ввода-вывода?
Пул слотов и пропускная способность шины
Методы прямой маршрутизации доказывают, что специализированные архитектуры памяти полностью устраняют перегрузку PCIe. Профильный движок инференса Strata работает с архитектурами вроде Qwen, удерживая в видеопамяти VRAM исключительно активные (горячие) эксперты и выгружая остальной массив в системную память или на физический накопитель. Предыдущие тесты зафиксировали работу модели Qwen3.8-Flash-Next на компьютере Mac M4 с 32 GB памяти со скоростью 13.5 токенов в секунду под управлением Strata. Чтобы воспроизвести избирательный стриминг весов нативно внутри Hugging Face Transformers, Tarek Ziadé построил базовую реализацию на основе OLMoE-1B-7B.
Первоначальный прототип на базе локального LRU-кэша и последовательного цикла на Python выдал 10.1 токена в секунду против 32 токенов в секунду на чистой версии Transformers. Причиной задержек оказалась оркестрация вычислительных ядер, а не скорость чтения с SSD. Переработка кэша в разделяемый предварительно выделенный пул слотов с таблицей поиска решила проблему, подняв скорость генерации до 34.6 токена в секунду против 38.1 токена в секунду при стандартном выполнении в памяти.
«Стриминг MoE-экспертов напрямую с SSD отстает от Strata по генерации токенов менее чем на 6%».
Подобная схема снимает аппаратный барьер, ранее делавший локальный инференс с оффлоадингом непригодным для коммерческих задач на рабочих станциях. Tarek Ziadé разработал кодовую базу с применением ИИ-инструментов разработки, подготовив пулл-реквест для Transformers, специализированные модули под модели и ядра на Metal, после чего опубликовал артефакты в репозитории tarekziade/moe-expert-streaming на платформе Hugging Face. Автономный загрузчик был направлен в основной репозиторий в качестве опции метода from_pretrained в рамках пулл-реквеста huggingface/transformers#50717.
Физические лимиты оборудования не позволят стримингу экспертов с SSD конкурировать с облачными кластерами по плотности многопользовательских запросов. Тем не менее для изолированных однопользовательских задач архитектура доказывает: штатный твердотельный накопитель обеспечивает достаточную пропускную способность шины для запуска моделей масштаба frontier, превращая локальный инференс MoE в экономически обоснованную альтернативу аренде серверных мощностей в облаке.
Что это значит
Отказ от дорогой видеопамяти в пользу обычного накопителя выглядит как аппаратный тупик, но разрыв в скорости со специализированным движком Strata составил меньше 6%. Вместо бесконечной закупки ускорителей инженеры просто перестали гонять через шину пассивные слои, задействуя накопитель как дешевое расширение памяти. Вместо покупки серверных стоек компании учатся выжимать десятки токенов из обычного диска.