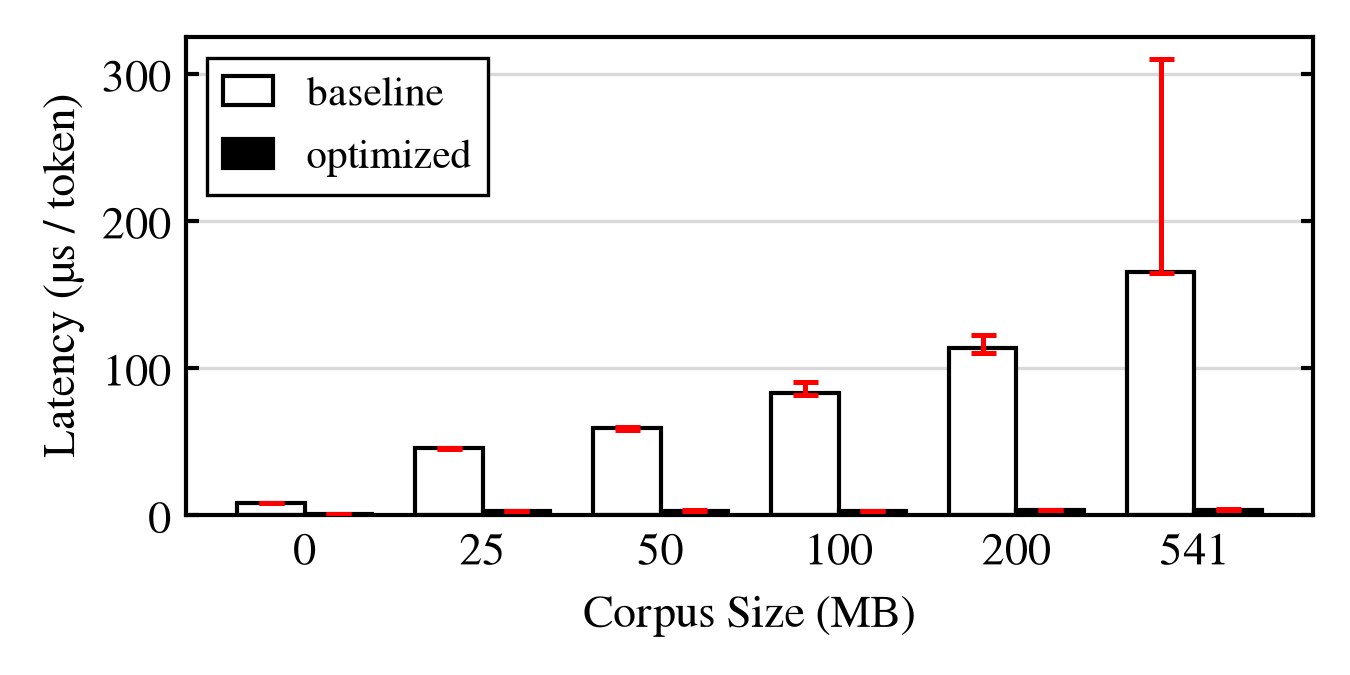
Декодирование с поиском по подсказкам (prompt lookup decoding) давно претендует на роль легкого пути к спекулятивному декодированию в таких движках вывода, как llama.cpp и vllm, а также в библиотеках вроде transformers от Hugging Face. Вместо того чтобы полагаться на второстепенную нейросеть для генерации черновых токенов — архитектуру, которая обычно создает дополнительные накладные расходы и головную боль при настройке, — декодирование с поиском по подсказкам задействует n-граммную модель, которая изучает историю токенов и выбирает кандидатов на основе наблюдаемой частотности. Это алгоритмический обходной путь, который полностью устраняет необходимость в громоздких черновых моделях.
Algorithmic Optimizations in Token Drafting Эти корректировки во многом опираются на базовые алгоритмы, разработанные Дэниелом Лемиром (Daniel Lemire) и Мартином Анкерлом (Martin Ankerl), превращая то, что когда-было изящным академическим трюком, в готовый к промышленной эксплуатации движок ускорения. Как отметил Мартин Анкерл по поводу реализации:
"Daniel Lemire sent in a PR that makes prompt lookup drafting upto 4.2x faster on top of my original optimizations."
The Architecture of Multi-Tier N-Gram Caching Система черновой генерации в llama.cpp достигает потрясающего прироста производительности — до 42 раз из коробки и до 140 раз с последующими запросами на слияние (pull requests) — благодаря жесткой трехуровневой структуре кэширования. Кэш контекста отслеживает n-граммы размером от 1 до 4 для токенов, которые в данный момент обрабатываются моделью, в то время как динамический кэш фиксирует частоту n-грамм в предыдущих запусках. Наконец, статический кэш хранит n-граммы размера 2, полученные из статического текстового корпуса, созданного с помощью утилиты llama-lookup-create.
Оценка производительности опирается на утилиту llama-lookup-stats, которая считывает текстовый файл и обрабатывает последовательность его токенов как вывод модели, чтобы протестировать спекулятивную генерацию черновиков под нагрузкой. За счет отказа от сложных архитектур черновой генерации в пользу оптимизированного отслеживания n-грамм эти доработки сокращают задержки и объем занимаемой памяти в 2,6 раза на локальном оборудовании. Для инженерных команд это не просто минорная оптимизация бенчмарков: это рубеж, переводящий запуск тяжелых локальных моделей из разряда дорогих и непрактичных экспериментов в жизнеспособную высокопроизводительную альтернативу облачным API.