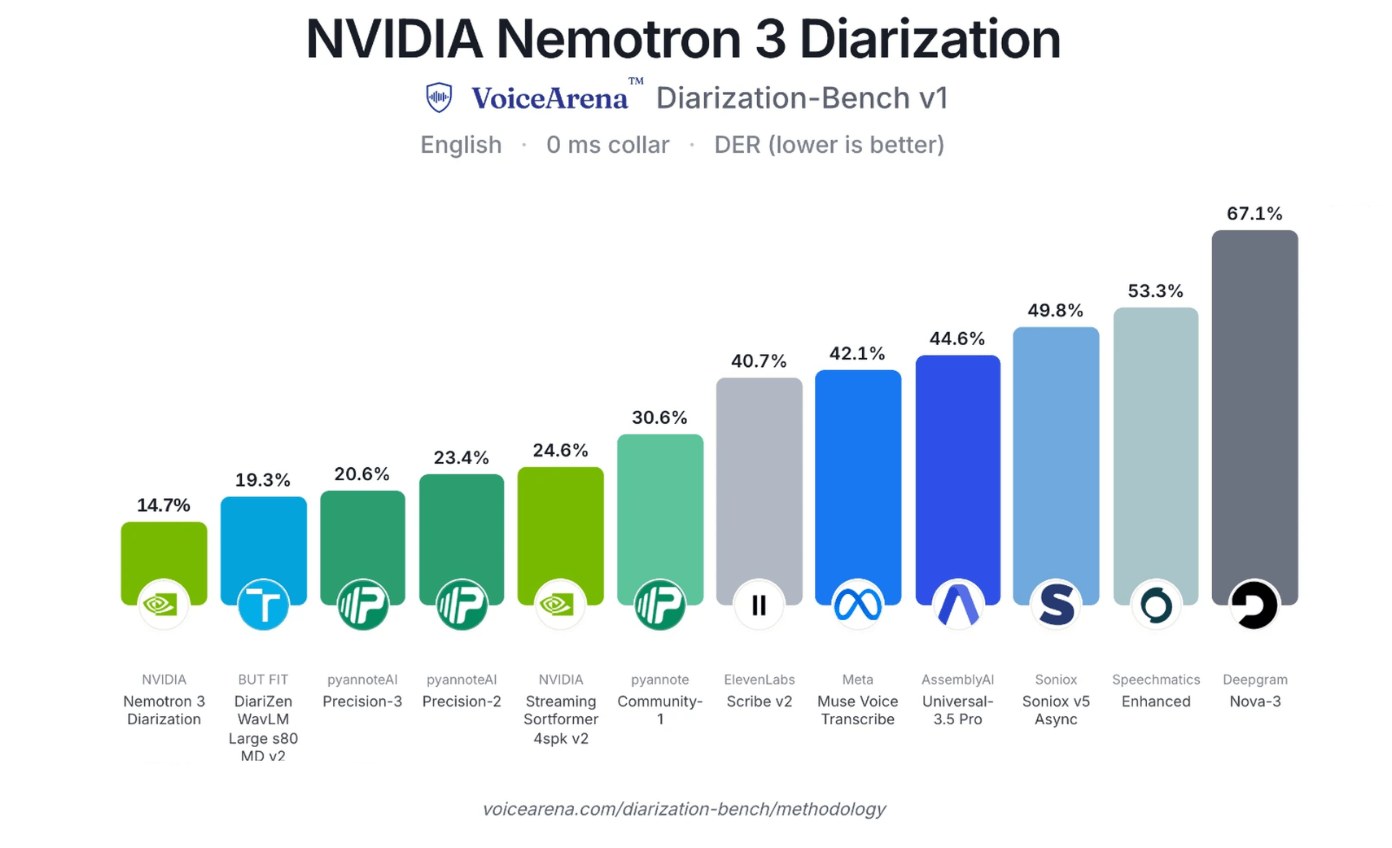
Nvidia выпустила Nemotron 3 Diarization — компактную модель на 100 миллионов параметров, созданную для отслеживания и разделения до восьми одновременных спикеров в режиме реального времени. Для компаний, которые тратят бюджеты на сторонние облачные API для расшифровки звонков в клиентской поддержке, этот локальный релиз предлагает прагматичный способ сократить накладные расходы.
Лидерство в бенчмарках и архитектура
В бенчмарке Diarization-Bench от VoiceArena модель Nemotron 3 Diarization заняла первое место с показателем ошибок 14,72 процента, обойди ближайшего конкурента с 19,3 процента. Бенчмарк применяет строгие критерии оценки, где накладывающаяся речь и незначительные несовпадения на границах переходов работают против системы. По сравнению с предшественницей, Streaming Sortformer, в восьми тестовых сценариях с буфером 1,04 секунды новая архитектура снижает уровень ошибок в среднем на 41 процент.
Контроль задержки и операционные ограничения
Система поддерживает разделение до восьми разных спикеров одновременно и включает явное обнаружение случаев, когда несколько участников говорят одновременно.
В паре с системой распознавания речи вроде Parakeet модель может выдавать стенограммы с метками спикеров, хотя и анонимными, вроде «speaker_2».
Инженеры могут настраивать обработку аудио через четыре пресета буфера — от 30,4 секунды до 0,32 секунды. Точность падает при работе с короткими конфигурациями буфера, а модель демонстрирует более высокие показатели ошибок в условиях сильного фонового шума, акустической реверберации или при большом количестве участников беседы.
Развертывание локальной модели на 100 миллионов параметров меняет юнит-экономику для процессов, утопающих в аудиоданных. Хотя фоновый шум и агрессивное уменьшение буфера все еще могут стать помехой, отказ от поминутной оплаты облачных API делает такой локальный инференс очевидным преимуществом для технических руководителей.